RTX 4070 12GBで翻訳LLMを徹底比較 — 話題のPLaMo 3 TranslateとGemma 4を実測レビュー
Preferred Networksから、待望の翻訳特化モデル「PLaMo 3 Translate」が登場しました。日本語処理に強いPFNが満を持して送り出した翻訳モデルとあって、ローカルLLMを常用する身としては試さずにはいられません。
そこで手元のPC環境(RTX 4070 12GB)を使い、対抗馬となるGemma 4(QAT+MTP構成)とガチンコの翻訳対決を実施しました。気になるのは短いフレーズを素早く返せるかだけではありません。数字や条件分岐の抜け漏れを起こさず、実務レベルの長文を最後まで破綻なく訳し切れるかが最大の焦点です。
検証にあたっては、PLaMo 3 Translateの0.8B・2B・8Bの3サイズと、Gemma 4のE2B・E4B・12Bを使用しました。Gemmaは投機的デコードを効かせるMTP(Multi-Token Prediction)を常時有効化し、思考あり・思考なしの両条件を測定。コンテクスト長は実用的な4,096トークンで統一し、通常測定324回と追加長文18回、合計342回にわたるテストを走らせました。
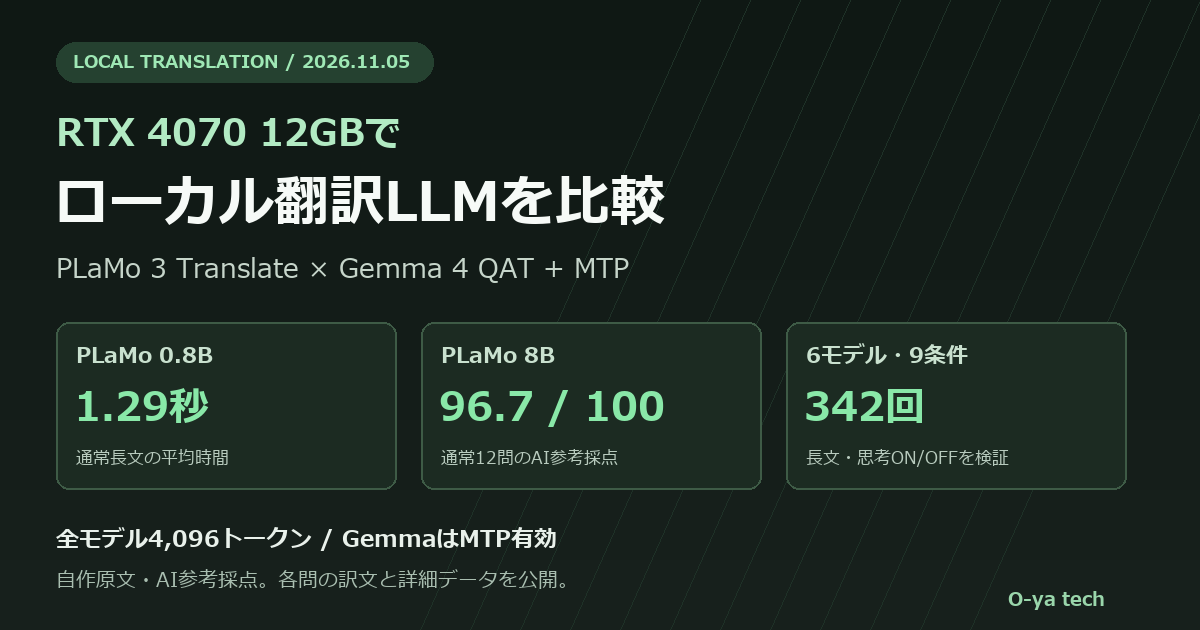
最速はPLaMo 0.8B。長文でも平均1.29秒で駆け抜ける驚異的な瞬発力を見せました。一方、正確性のAI参考採点ではPLaMo 8Bが96.7点と高い安定感を発揮。対照的に、Gemma 12Bの思考ありモードは思考トークンだけで枠を使い果たし、長文の最終訳が出力できない場面に遭遇しました。
※採点はCodexによる原文との照合結果を定量化した参考スコアです。人間による官能評価とは異なります。
対決モデルのラインナップとサイズ感
今回の比較対象は、パラメータ規模の異なる各3サイズです。手元のRTX 4070(VRAM 12GB)で全レイヤーをGPUに載せ切る前提で選定しました。
- 超軽量クラス(PLaMo 0.8B / Gemma E2B):VRAM消費が数GBに収まる極小サイズ。エントリーGPUやCPU環境、常駐型ツールでも軽快に動く身軽さが武器です。0.8Bという小ささでどこまでまともな日本語を出せるのかが大きな見どころになります。
- バランス・本命クラス(PLaMo 2B / Gemma E4B):個人開発や日常利用のスイートスポットとなるサイズ。軽快な動作と表現力を両立できるか、実用性の基準となるクラスです。
- 重量級クラス(PLaMo 8B / Gemma 12B):12GBのVRAMをしっかり使い切る本格派。文脈の深い読み取りや複雑な構文の把握に期待がかかる一方、処理速度とのトレードオフが問われます。
速度は「訳し終わるまで」の実時間で比べる
モデルによってトークナイザーの区切り方は異なります。思考モードを有効にした場合、出力トークン数には翻訳結果に出てこない思考過程のトークンも含まれるため、単なるtokens/sでは純粋な待ち時間を比較できません。そこで今回は、ユーザーが翻訳をリクエストしてから、画面に最終訳が出揃うまでの実時間(秒)を評価の主指標としました。
短文4問・中長文4問・長文4問の各テキストを3回ずつ測定し、原文ごとの中央値をもとに長さの区分別平均を算出しています。英語の長文は約490語、日本語の長文は約1,200字です。
| モデル / 思考条件 | 短文(秒) | 中程度(秒) | 長文(秒) | AI参考点 /100 | 正常終了率 |
|---|---|---|---|---|---|
| PLaMo 0.8B | 0.09 | 0.36 | 1.29 | 91.3 | 36/36 |
| PLaMo 2B | 0.21 | 0.81 | 3.08 | 95.0 | 36/36 |
| PLaMo 8B | 0.47 | 2.03 | 7.47 | 96.7 | 36/36 |
| Gemma E2B(思考なし) | 0.74 | 1.20 | 3.55 | 88.8 | 36/36 |
| Gemma E2B(思考あり) | 2.94 | 2.93 | 5.82 | 94.2 | 36/36 |
| Gemma E4B(思考なし) | 0.83 | 1.42 | 4.60 | 94.2 | 36/36 |
| Gemma E4B(思考あり) | 3.32 | 3.60 | 8.85 | 93.8 | 36/36 |
| Gemma 12B(思考なし) | 0.60 | 2.73 | 11.95 | 95.0 | 36/36 |
| Gemma 12B(思考あり) | 10.49 | 20.41 | 55.23 ※ | 81.3 | 30/36 |
※Gemma 12B(思考あり)の長文55.23秒は、エラーで停止するまでの時間を含んでいます。長文4問のうち2問で思考枠が溢れて最終訳が出力できず、正常終了は30/36回にとどまりました。他の8条件はすべて36/36回完走しています。
実際に動かしてみて一番驚いたのは、PLaMo 0.8Bの爆発的なスピードです。短文は0.09秒と押した瞬間に返ってきますし、500語近い長文でもわずか1.29秒。通常12問の中央値をすべて合計しても約6.96秒しかかかりません。ブラウザ拡張機能やバックグラウンド常駐ツールで使うなら、この反応速度は圧倒的な魅力です。
PLaMo 2Bも合計約16.42秒(長文平均3.08秒)と極めて快調。PLaMo 8Bは合計約39.91秒(長文平均7.47秒)とそれなりに待ち時間は伸びるものの、実用圏内を維持しています。
正確性の採点と、実際の誤訳から見る考察
翻訳の質については、Codexを用いて原文と訳文の照合を行いました。意味の保持に6点、情報の完全性に3点、数値や固有名詞・指定言語の維持に1点を配分した10点満点です。文体の好みの違いでは減点せず、事実関係の欠落や数値の食い違いを厳格に減点しました。全14問×9条件の計126件を個別に採点しています。
| モデル / 思考条件 | 通常12問 /120 | 通常100点換算 | 追加長文 /20 | 全14問100点換算 |
|---|---|---|---|---|
| PLaMo 8B | 116.0 | 96.7 | 17.5 | 95.4 |
| PLaMo 2B | 114.0 | 95.0 | 17.5 | 93.9 |
| Gemma 12B(思考なし) | 114.0 | 95.0 | 17.5 | 93.9 |
| Gemma E2B(思考あり) | 113.0 | 94.2 | 13.7 | 90.5 |
| Gemma E4B(思考なし) | 113.0 | 94.2 | 15.5 | 91.8 |
| Gemma E4B(思考あり) | 112.5 | 93.8 | 16.5 | 92.1 |
| PLaMo 0.8B | 109.5 | 91.3 | 15.5 | 89.3 |
| Gemma E2B(思考なし) | 106.5 | 88.8 | 13.5 | 85.7 |
| Gemma 12B(思考あり) | 97.5 | 81.3 | 1.3 | 70.6 |
最高得点はPLaMo 8Bの96.7点。続いてPLaMo 2BとGemma 12B(思考なし)が95.0点で並びました。ここで興味深いのは、点数差以上に「モデルサイズごとの文脈理解の壁」がはっきりと訳文に現れた点です。
スピードと引き換えに起きた、小さな意味の反転
価格変動に関する次の短い英文で、サイズによる差が分かりやすく出ました。
The price fell by 15%, not to 15% of its original value.
PLaMo 0.8Bの訳文は「価格は15%下落し、元の価値の15%には届きませんでした」。元値の15%にまで暴落したわけではないという対比表現が、なぜか目標値に到達しなかった話にすり替わっています。文章自体は流暢な日本語に見えるため、パッと見では誤訳に気付きにくい怖さがあります。極小モデルを実務で使う際は、こうした数値の対比関係に対する目視チェックが欠かせません。
「採用」をhireと訳すか、adoptionと訳すか
日本語の文脈理解でも差がつきました。
採用に賛成したわけではない。試作品は3個とも動いたものの……
この文章に対し、PLaMo 0.8Bや2B、Gemma E2B(思考なし)などは「採用」を雇用を意味するhiringやhireと訳してしまいました。前後の文脈を見れば機械や技術の採用(adoption / acceptance)であることは明白ですが、小型モデルでは単語単体の頻出訳に引きずられがちです。
一方でPLaMo 8Bや思考ありモデルは、試作品の話であることをしっかり踏まえて適切な英単語を選択していました。このあたりに8Bクラスの確かな基礎体力を感じます。
なお、全モデルに共通して見られた弱点もありました。返金ポリシーの「after November 12」を「11月12日以降」と訳して12日当日を含めてしまうような、日付や境界条件のずれです。この手の法的な限定表現は、モデルのサイズを問わず慎重な確認が必要です。
長文耐久テストと思考モードの落とし穴
続いて、通常の長文2本を連結したヘビーなテスト(英語約978語、日本語2,426字)を実施しました。実務でよくある長い仕様書や議事録を一括で流し込んだときに、途中で息切れせず完走できるかを試す試験です。
| モデル / 思考条件 | 英→日(所要時間・結果) | 日→英(所要時間・結果) |
|---|---|---|
| PLaMo 0.8B | 2.50秒 / 完走 | 2.25秒 / 完走 |
| PLaMo 2B | 5.98秒 / 完走 | 5.44秒 / 完走 |
| PLaMo 8B | 14.39秒 / 完走 | 13.24秒 / 完走 |
| Gemma E2B(思考なし) | 6.85秒 / 完走 | 5.18秒 / 完走 |
| Gemma E2B(思考あり) | 8.81秒 / 完走 | 8.53秒 / 途中で上限到達 |
| Gemma E4B(思考なし) | 9.43秒 / 完走 | 6.73秒 / 完走 |
| Gemma E4B(思考あり) | 11.87秒 / 完走 | 10.63秒 / 完走 |
| Gemma 12B(思考なし) | 29.60秒 / 完走 | 21.56秒 / 完走 |
| Gemma 12B(思考あり) | 48.93秒 / 訳なし(上限到達) | 44.91秒 / 途中で上限到達 |
考察:翻訳タスクにおける「思考モード」の功罪
この長文テストの結果には、非常に示唆に富む学びがありました。
PLaMo 3兄弟は、0.8Bから8Bまで両方向とも一切息切れすることなく、末尾まで安定して訳し切りました。Gemmaも思考なしモードであれば全サイズ完走しています。
問題となったのはGemmaの思考ありモードです。E2Bは日→英の2文書目で途切れ、12Bに至っては英→日で約49秒間も思考を延々と出力し続けた挙句、4,096トークンの上限枠を使い切り、肝心の最終訳が1文字も出ずに強制終了してしまいました。
近年のLLMでは推論・思考プロセス(CoT)を挟む手法がトレンドです。しかし翻訳タスクにおいては、内部で延々と長考させる行為はトークン枠の浪費に繋がりやすく、むしろ大きな足かせになりかねません。特にコンテクスト長に制限があるローカル環境では、思考トークンが出力枠を圧迫し、一番欲しい訳文が溢れてしまうという本末転倒な事態を招きます。
その点、PLaMo 3 Translateのように「最初から翻訳専用としてファインチューニングされたモデル」は無駄な自問自答を挟まず、ストレートに最適な訳文を吐き出します。出力枠を100%訳文に使えるため、長文でも圧倒的に安全で実用的でした。特化型モデルならではの強みが如実に現れた格好です。
GemmaのMTP(投機的デコード)動作確認
Gemma側の公平性を担保するため、MTP(Multi-Token Prediction)を確実に機能させました。使用した配布物はMTPヘッドが別ファイルになっていたため、LM Studioの起動引数にドラフター設定を直接流し込んでいます。
--model-draft <対応するMTPヘッドのGGUF>
--spec-type draft-mtp
--spec-draft-n-max 4
ランタイムのログを追跡し、ドラフトトークンの生成数と採択数を1リクエストごとに照合。通常測定216回と追加長文12回、計228回のGemma推論すべてでMTPによるドラフト採択が正常に行われていることを確認済みです。
測定環境とベンチマークの条件
検証を行ったハードウェアと共通パラメータは以下の通りです。
| 項目 | 設定内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 4070 Laptop / VRAM 12GB |
| CPU / メモリ | Intel Core i5-14500HX / 32GB RAM |
| 推論ランタイム | LM Studio(llama.cpp CUDA12 2.69.0 / SDK 2.1.0) |
| 量子化形式 | PLaMo: Q4_K_M / Gemma: QAT Q4_0(MTPヘッドはQ8_0) |
| コンテクスト長 | 全モデル共通 4,096トークン(並列数1) |
| サンプリング設定 | temperature=0, top-k=1, seed=42, repeat penalty=1 |
| GPUオフロード | 全レイヤーGPU配置(Flash Attention有効、KVキャッシュf16) |
| 測定回数 | 通常12問×9条件×3回=324回、追加長文2問×9条件×1回=18回(計342回) |
キャッシュ処理・プロンプト・詳細設定について
測定前には英日・日英のウォームアップを実施し、各推論の直前に無関係なダミートークンを生成させて直前プロンプトのキャッシュ効果をリセットしています。PLaMoは公式推奨のPFML3翻訳プロンプト、Gemmaは標準チャットテンプレートに忠実な全文翻訳指示を与えました。量子化方式や内部マイクロバッチサイズに細かな差異があるため、実機環境における構成比較としてご覧ください。
詳細データと再現用ファイル
今回の検証で使用した自作原文、全342回の生データ、各モデルの訳文、採点の内訳と減点理由はすべてオープンにしています。
- 各問の点数・内訳・全減点理由(Markdown)
- 採点データ一式(JSON)
- 自作テスト原文とチェック項目(通常12問+追加2問)
- 全342回の測定サマリー・最終訳文・MTP統計
- 思考文を含む推論ログ全文(JSONL)
- モデル識別子・設定・ハードウェア詳細
- データ構成と追試スクリプトの解説 / SHA-256チェックサム
結論:ローカル翻訳用途ならどれを選ぶべきか?
今回の徹底検証を通じて、用途に応じた明確な住み分けが見えてきました。
- 常用エンジンとしてのベストバイは「PLaMo 2B」: 長文でも約3秒という軽快なレスポンスを維持しつつ、AI参考採点では8B(96.7点)に肉薄する95.0点をマーク。VRAMを圧迫せず、普段使いの翻訳エンジンとして最もバランスが取れています。ローカル翻訳の第一候補として強くおすすめできます。
- 常駐・リアルタイム重視なら「PLaMo 0.8B」: 長文1.29秒という圧倒的な俊敏性は唯一無二。Webブラウジング中のポップアップ翻訳や、チャットツールのリアルタイム翻訳など、待ち時間を極限まで削りたい場面で無類の強さを発揮します。ただし数値の対比や否定条件で読み違えることがあるため、ざっくりとした大意把握に向いています。
- 契約書・技術仕様など精度最優先なら「PLaMo 8B」: 「試作品の採用」の文脈を正しく見抜くなど、読解力は一段上です。待ち時間は長文で7秒前後かかりますが、誤訳のリスクを少しでも下げたい重要な文書ではこの頼もしさが光ります。
- Gemmaを使うなら「思考なし」一択: Gemmaを翻訳用途で使う場合、思考モードはオフにするのが賢明です。思考なしであればE4Bも12Bも極めて優秀で安定した翻訳を出力してくれます。
Preferred NetworksのPLaMo 3 Translateは、翻訳という明確な目的に対して無駄を削ぎ落とした、非常に実用的で完成度の高いモデル群に仕上がっていました。ぜひ手元のローカル環境でその軽快さを体験してみてください。